Datakwaliteit verbeteren voor AI: waarom uw data de bottleneck is
AI faalt zelden aan de techniek maar aan de data: inconsistente formaten, dubbele records, ontbrekende velden en data in hoofden.…
Als u zich ooit verdwaald voelde tussen ChatGPT, Claude, Gemini, Llama, “tokens”, “parameters” en “agents”, dan bent u niet alleen. Het AI-landschap lijkt een oerwoud omdat bijna niemand u de kaart heeft gegeven. Deze gids is die kaart.
We bouwen het rustig op, als een leerpad. U begint bij nul: wat zo’n model echt ís. Daarna de geschiedenis die alles verklaart, de modelfamilies met hun karakters, de grenzen en ethiek, en waar dit naartoe gaat. Aan het einde kunt u niet alleen meepraten: u maakt zelfstandig bewuste keuzes.
Een LLM is een machine die het volgende woord voorspelt. Dat is alles. Large Language Model: een model van taal, gebouwd op een onvoorstelbaar grote berg tekst. Vraag het “de hoofdstad van Frankrijk is…” en het berekent dat “Parijs” de meest waarschijnlijke voortzetting is. Doe dat duizenden keren achter elkaar en er ontstaat een coherent antwoord.
Maar hoe wordt “woordjes raden” schrijven, vertalen en programmeren? Omdat taal zelf kennis bevat. Wie biljarden teksten leest, leert niet alleen grammatica maar ook feiten, logica, stijl en menselijke patronen. Een voldoende groot patroonmodel wordt bijna bij toeval een kennismodel.
Concreet wordt dat zo: op de prompt “De kat zat op de…” produceert het model geen één antwoord maar een kansverdeling over álle woorden die het kent:
| Kandidaat-woord | Berekende kans |
|---|---|
| mat | 41% |
| vensterbank | 18% |
| tafel | 9% |
| stoep | 5% |
| …tienduizenden andere opties | 27% |
Het kiest (met een beetje toeval) uit die verdeling, voegt het woord toe en berekent opnieuw. Elke zin is een reeks van deze trekjes. Dat mechanisme, schijnbaar simpel, is de motor onder alles wat AI kan.
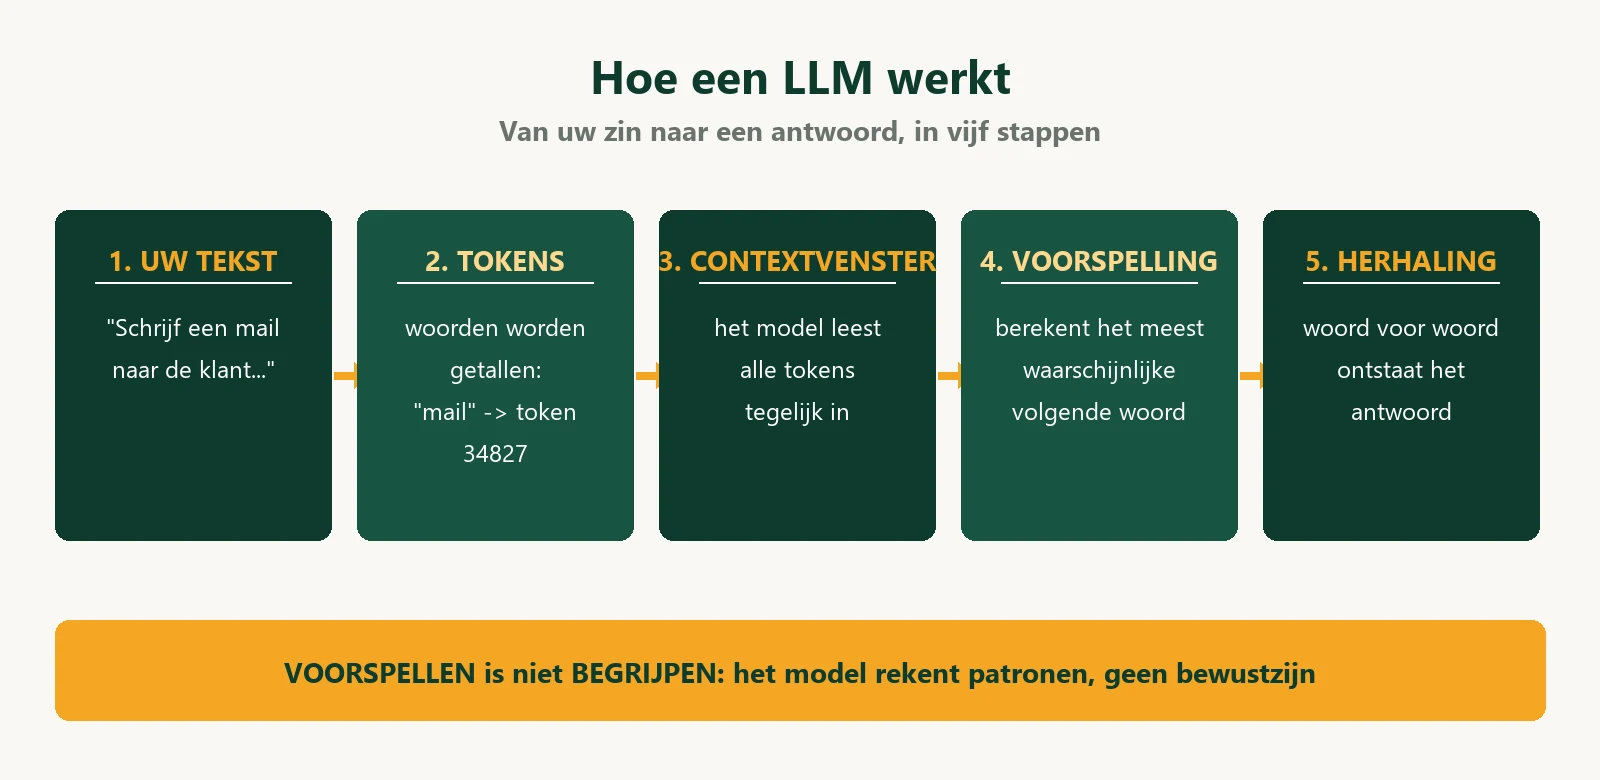
Weetje: het token-principe verklaart waarom AI soms raar telt. Vraag hoeveel letters in “aardbei” zitten en het model faalt regelmatig, want het ziet tokens, geen letters. Het leest geen tekst zoals u dat doet.
Het idee is ouder dan u denkt. In 1958 bouwde Frank Rosenblatt de perceptron: een elektronisch “neuron” dat kon leren lijnen te trekken tussen categorieën. Het werkte, maar kon te weinig. Tientallen jaren van stilte volgden: de “AI-winters”.
De omslag kwam in drie stappen. In 2012 won een deep learning-netwerk (AlexNet) ruim de grote beeldherkennings-wedstrijd ImageNet: plotseling werkten diepe neurale netwerken beter dan al het handgemaakte. In 2013 liet Google’s word2vec zien dat woorden als punten in een betekenisruimte voorgesteld kunnen worden, waardoor “koning minus man plus vrouw” wiskundig naar “koningin” wijst. Taal werd meetbaar.
Maar er bleef één groot probleem: de toen gangbare modellen (RNN’s) lazen tekst woord voor woord en vergaten het begin tegen het einde. Lange zinnen, lange documenten: steeds waziger. In 2017 publiceerden Google-onderzoekers “Attention is All You Need”. De Transformer kon naar álle woorden in een tekst tegelijk “kijken” en hun onderlinge relaties wegen, parallel in plaats van opeenvolgend. Niet vergeten, niet serieel: meteen alles in context. Dat maakte schaal mogelijk.
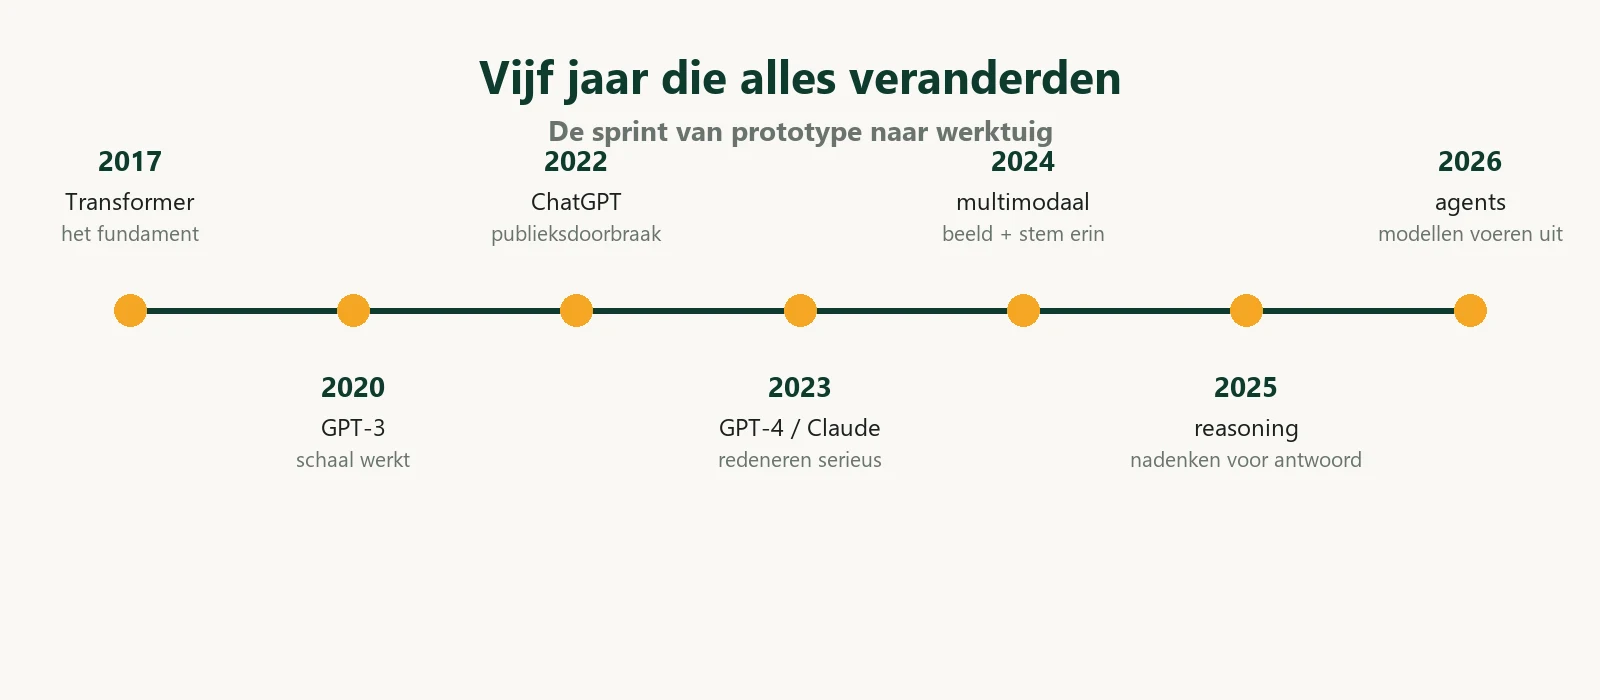
Wat daarna gebeurde was een explosie van schaal. GPT-3 (2020) toonde dat een groot genoeg model verrassende vaardigheden “gratis” kreeg. ChatGPT (eind 2022) maakte het publiek. GPT-4 (2023) maakte het serieus. Sindsdien is de race: ieder kwartaal verschuift de grens. In 2025 arriveerden reasoning-modellen die eerst “nadenken” voordat ze antwoorden; in 2026 zijn het vooral agents die uitvoeren in plaats van alleen schrijven.
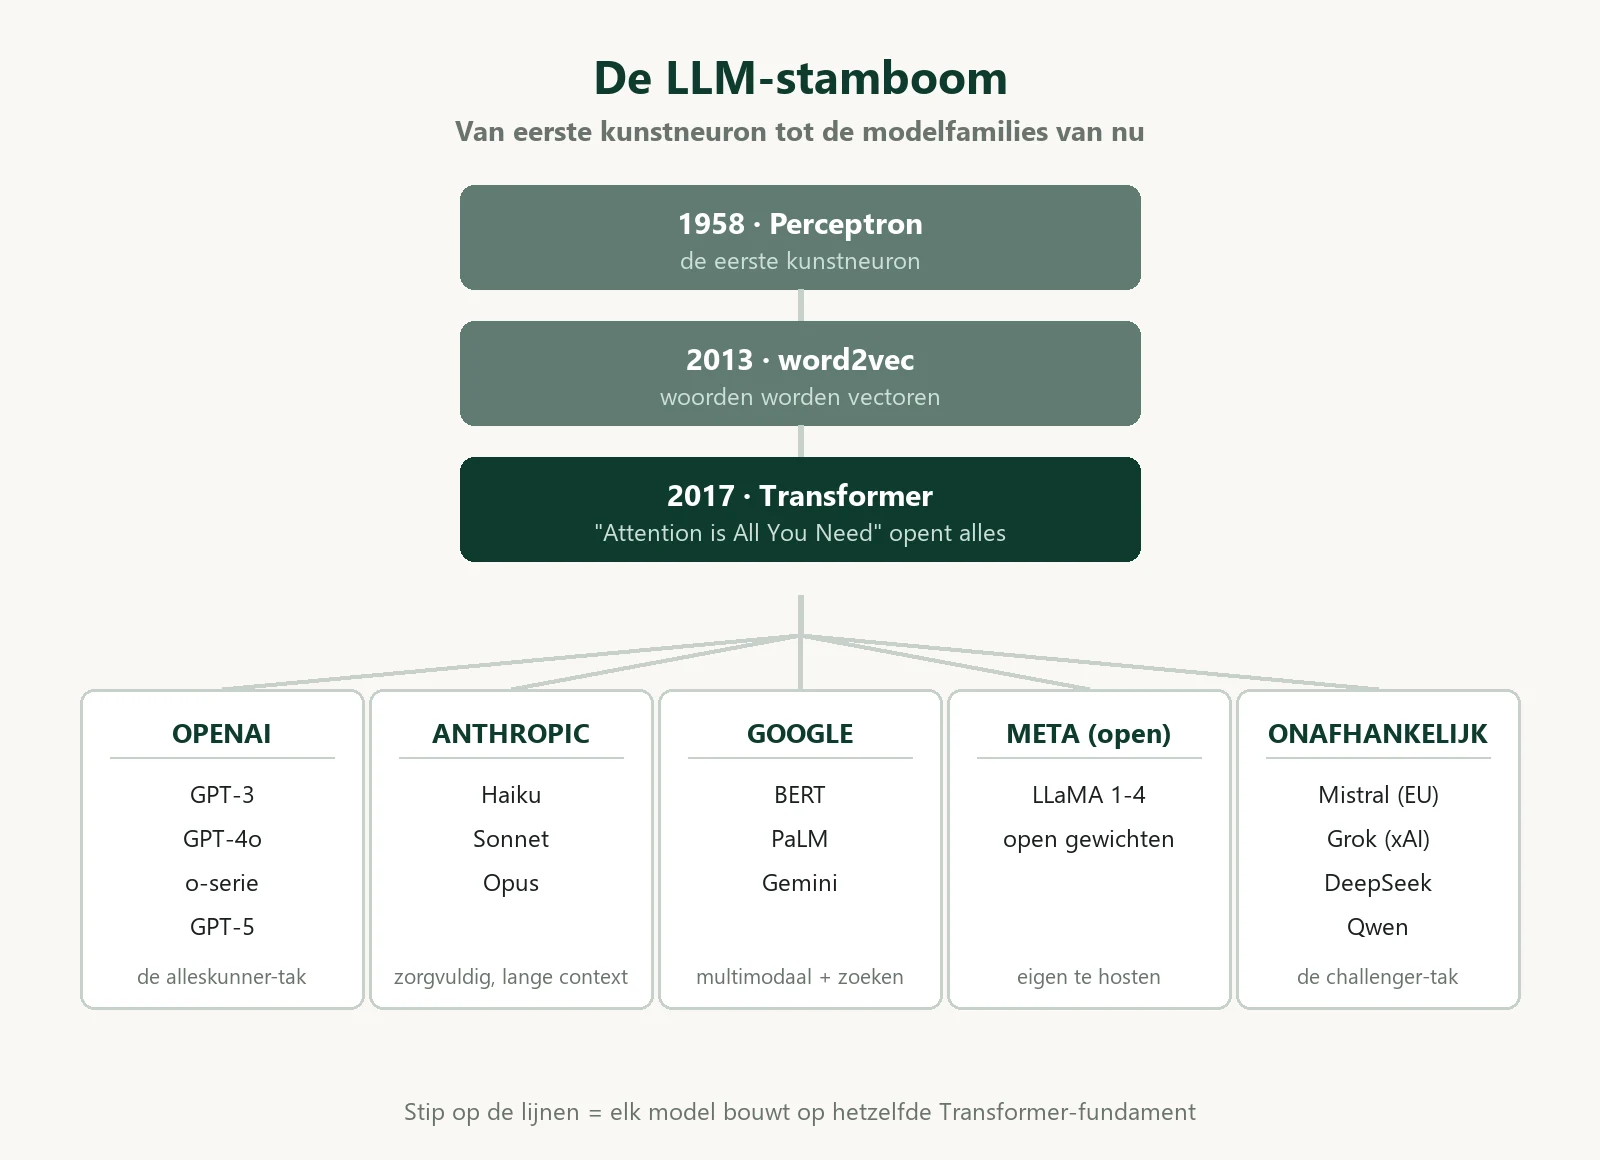
Vrijwel elke LLM die u kent stamt van hetzelfde Transformer-fundament af. De verschillen zitten in de takken: wie het model bouwde, met welke data, voor welk doel, en hoe open het is.
| Familie | Modellen | Karakter | Sterk in |
|---|---|---|---|
| OpenAI | GPT-4o, o-serie, GPT-5 | De alleskunner en marktleider | Algemeen gebruik, redeneren, breed ecosysteem |
| Anthropic | Claude Haiku, Sonnet, Opus | Zorgvuldig, nuchter, veiligheids-focus | Lange documenten, nuancering, programmeren |
| Gemini 2.5-serie | Multimodaal geboren, zoek-integratie | Beeld+tekst samen, enorme context, live data | |
| Meta | LLaMA 4-familie | Open gewichten, draait overal | Eigen hosting, aanpassen, geen lock-in |
| Mistral (EU) | Mixtral, Mistral Large | Europees, efficiënt, open-leaning | Snelheid per euro, EU-datalocatie-opties |
| Challengers | DeepSeek, Qwen, Grok | Verrassend sterk, spotgoedkoop | DeepSeek vooral redeneren; Grok: X-integratie |
Weetje: “GPT” staat voor Generative Pre-trained Transformer: letterlijk de drie eigenschappen die de revolutie maakten. En “Claude” is vernoemd naar Claude Shannon, de vader van de informatietheorie.
De belangrijkste tweedeling is niet het merk maar open of gesloten. Gesloten modellen (OpenAI, Anthropic, Google) bereikt u via hun dienst: handig, maar uw data gaat naar hun servers en u betaalt per gebruik. Open modellen (LLaMA, Mistral, DeepSeek, Qwen) downloadt u en draait u zelf, op uw eigen servers, met uw eigen data, zonder dat iemand meekijkt. Voor privacygevoelige toepassingen is dat vaak de doorslag. Lees daarover onze gids over private AI en AVG.
Waarom gedraagt een LLM zich zoals het doet? Het antwoord zit in drie trainingsfases:
Een concreet voorbeeld van wat fine-tuning doet. Basismodel op “Hoe maak ik een cv?”: “cv maken sollicitatiebrief voorbeeld downloaden gratis template word…”een continue van zoektermen. Instructiemodel op dezelfde vraag: “Een sterk cv bestaat uit vijf onderdelen. Begin met…”een gestructureerd antwoord. Zelfde kennis, ander gedrag.
De vierde, nieuwste stap is reasoning-training: modellen die leren eerst een ketting van tussenstappen te produceren en pas daarna te antwoorden. Dat maakt ze veel sterker in wiskunde, logica en code, ten koste van snelheid en kosten. U ziet het als de “denk…”-fase in tools als o-serie en DeepSeek.
Het geheim van de Transformer is een mechanisme genaamd attention. Waar oudere modellen woord voor woord lazen en het begin vergaten, kan een Transformer elk woord in relatie tot elk ander woord wegen.
Neem: “De bank zat vol, dus ik ging ergens anders zitten.” Een mens weet dat “bank” hier meubel betekent, geen geldinstituut. Attention doet hetzelfde: het woord “bank” kijkt naar “zitten” en “vol” en krijgt daardoor de juiste betekenis toegewezen. Dat gebeurt niet één keer maar in honderden parallelle lagen tegelijk, waardoor grammatica, stijl, logica en context allemaal tegelijk meewegen.
De andere stille kracht is de embedding: elk woord wordt een punt in een enorme betekenisruimte. “Hond” ligt dicht bij “puppy” en ver van “hypotheek”. Omdat betekenis meetbaar wordt, kan het model synoniemen herkennen, toon oppikken en analogieën volgen zonder dat iemand dat ooit uitlegde.
En dan de temperatuur: de knop die bepaalt hoe voorspelbaar het model kiest uit die kansverdeling. Lage temperatuur pakt steeds het veiligste woord (droog, correct, voorspelbaar). Hogere temperatuur laat het onverwachte vaker winnen (creatiever, maar foutgevoeliger). Merkt u dat antwoorden te generiek zijn? Temperatuur is meestal de schuldige instelling.
Het vreemdste fenomeen van dit veld: emergente vaardigheden. Kleine modellen deden niets bijzonders, maar ergens boven de honderd miljard parameters ontstonden vaardigheden die niemand erin programmeerde: meerstaps-redeneren, vertalen tussen talen waarop het nauwelijks getraind was, code begrijpen.
Niemand kan volledig uitleggen waarom schaal dit oplevert. De meest geaccepteerde intuïtie: taal bevat zoveel van de wereld dat een voldoende groot patroonmodel onvermijdelijk ook modellen ván die wereld opbouwt. Alsof u zo lang timmermans-handboeken leest dat u op een dag weet hoe een dakconstructie werkt, zonder ooit een hamer vastgehouden te hebben.
| Sterk | Zwak |
|---|---|
| Taal begrijpen en produceren in elke stijl | Feiten: ze hallucineren met overtuiging |
| Samenvatten, herstructureren, vertalen | Nauwkeurig rekenen zonder hulpmiddelen |
| Code schrijven en debuggen | Nieuwe kennis na de trainingsdatum |
| Redeneren met voldoende context | Weten wát ze niet weten |
| Eindeloos geduld en volume | Gezond verstand in de echte wereld |
Weetje: dat een LLM vloeiend Nederlands schrijft is op zich opmerkelijk: de meeste trainingsdata is Engels. Het Nederlands “leerde” het bijna bij toeval mee, wat verklaart waarom het soms steenkolen-Engelse constructies gebruikt.
Een kale LLM is een gesprekspartner. De kracht voor bedrijven zit in wat eromheen gebouwd wordt:
De vuistregel voor volgorde: begin met een goed uitgeschreven prompt, voeg RAG toe zodra het over uw eigen data gaat, gebruik agents wanneer het model ook iets moet dóen, en overweeg fine-tuning pas als de rest bewezen werkt.
Dit deel overslaan veel gidsen, maar het hoort bij volwassen gebruik:
De meeste mensen kiezen een model op gevoel. Zo doet u het als professional:
Geen glazen bol, maar de richting is zichtbaar:
Wat dat voor u betekent: bouw niet op één model maar op een architectuur. Leg uw processen, data en integraties zo vast dat u het model kunt wisselen als de markt verschuift. Want dat gebeurt.
| Term | Wat het echt betekent |
|---|---|
| Prompt | Wat u invoert; uw opdracht aan het model |
| Hallucinatie | Het model verzint aannemelijk klinkende onzin |
| Inference | Het daadwerkelijke genereren; waar u voor betaalt |
| Context window | Het “werkgeheugen”: hoeveel tekst tegelijk meedoet |
| Fine-tuning | Een model bijleren op specifieke data of stijl |
| Multimodaal | Naast tekst ook beeld, audio of video |
| Open weights | De geleerde parameters zijn vrij te downloaden |
| System prompt | De onzichtbare instructies die het gedrag sturen |
| Benchmark | Gestandaardiseerde test om modellen te vergelijken |
| MoE (Mixture of Experts) | Alleen relevante “expert-delen” activeren per vraag: sneller en goedkoper |
| U wilt | Overweeg |
|---|---|
| Een dagelijkse alleskunner | GPT-5 of Claude Sonnet |
| Lange documenten doorploegen | Claude (context) of Gemini (groot venster) |
| Privacygevoelige data eigen terrein | LLaMA of Mistral self-hosted |
| Beeld en tekst samen | Gemini of GPT-5 |
| Zo goedkoop mogelijk schalen | Mistral, DeepSeek, kleine Haiku-tier |
| Code en technisch werk | Claude Sonnet/Opus of gespecialiseerde modellen |
Aan het begin leek dit een onoverzichtelijk oerwoud. Nu ziet u het patroon: één fundament (de Transformer), een handvol families met elk hun karakter, dezelfde vier grenzen, en een gereedschapskist die van een gespreksrobot een werkinstrument maakt. De namen zullen blijven veranderen, maar het raamwerk dat u nu heeft blijft kloppen.
Wilt u deze kennis omzetten in iets dat voor uw bedrijf werkt? De verdieping vindt u in onze uitgebreide geschiedenisde vergelijking ChatGPT vs Claude vs Gemini en onze gids voor AI in het MKB. Of praat direct met ons: wij ontwerpen en bouwen AI-oplossingen voor bedrijven die het serieus willen aanpakken.
Large Language Model: een model dat taal voorspelt. 'Large' verwijst naar de miljarden parameters; 'Language' naar de trainingsdata; 'Model' naar het patroon-geheel dat wordt opgebouwd.
ChatGPT is het product (de app); GPT-4o of GPT-5 is de LLM erin. Zo is uw browser niet het internet maar het raam ernaartoe.
Er is geen 'beste', er is 'beste voor uw taak'. Voor dagelijks gebruik GPT-5 of Claude; voor privacy-gevoelig werk open modellen; voor beeld+tekst Gemini. De gids toont de keuzehulp.
Het simuleert redeneren via patronen uit tekst, niet via bewustzijn. De resultaten lijken op denken, maar het model 'begrijpt' niets zoals een mens dat doet.
AI & automatisering door de specialisten van Webgilde. Eerste analyse gratis en vrijblijvend.
SEO & content lead bij Webgilde. Wij schrijven alleen over wat wij dagelijks zelf uitvoeren voor klanten.
AI faalt zelden aan de techniek maar aan de data: inconsistente formaten, dubbele records, ontbrekende velden en data in hoofden.…
Slechts 2-3% van de mkb-bedrijven heeft AI structureel ingebed versus 22% die experimenteert. De AI-volwassenheidsschaal loopt van bewustzijn tot autonome…
Quote-to-cash (QTC) is de keten van offerte tot betaling: configureren, prijzen, offerte genereren, contracteren, factureren en innen. Handmatige QTC-processen kosten…
Ontdek in een gratis gesprek waar uw grootste online kansen liggen.
Plan gratis groeiscanOntdek in een gratis gesprek waar uw grootste online kansen liggen. Geen verplichtingen, wel een concreet plan.
Plan gratis groeiscan